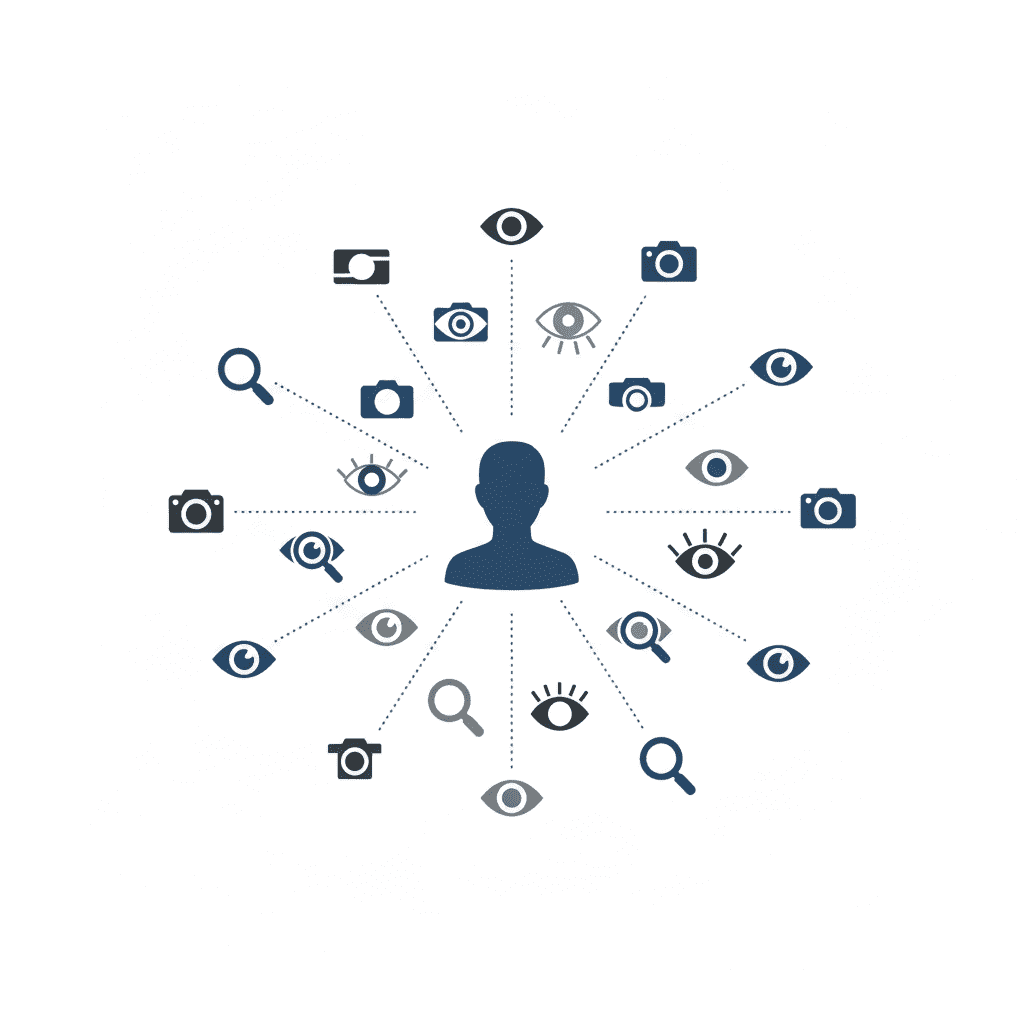
Stalo se ti někdy, že jsi se na YouTube podíval na jedno video o psech a najednou ti YouTube začal nabízet spoustu dalších videí se psy? Nebo že ti Instagram ukazuje jen fotky tvých oblíbených herců? To není náhoda! Za vším stojí chytří pomocníci, kterým říkáme algoritmy. Tyto algoritmy tě neustále sledují, učí se, co máš rád, a pak ti nabízejí obsah na míru. Pojďme se podívat, jak to funguje a na co si dát pozor.
Každá tvoje aktivita na internetu zanechává digitální stopu. Aplikace a webové stránky tyto stopy sbírají.
Sledování uživatele je sbírání dat o tom, co děláš online: na co klikáš, co si prohlížíš, co "lajkuješ", jak dlouho se na něco díváš, a dokonce i kde se nacházíš.
Hlavním důvodem je, aby ti mohli nabídnout obsah a reklamy, které tě budou zajímat. Cílem je udržet tě na stránce nebo v aplikaci co nejdéle.
Každá sociální síť (TikTok, Instagram, Facebook, YouTube) má svůj vlastní tajný recept – algoritmus. Tento algoritmus rozhoduje, v jakém pořadí a jaký obsah ti ukáže.
Algoritmus sociální sítě je soubor pravidel, který automaticky třídí a vybírá příspěvky, fotky a videa, které se ti zobrazí.
Výsledkem sledování a práce algoritmů je personalizace obsahu. To znamená, že obsah, který vidíš, je přizpůsobený přímo tobě.
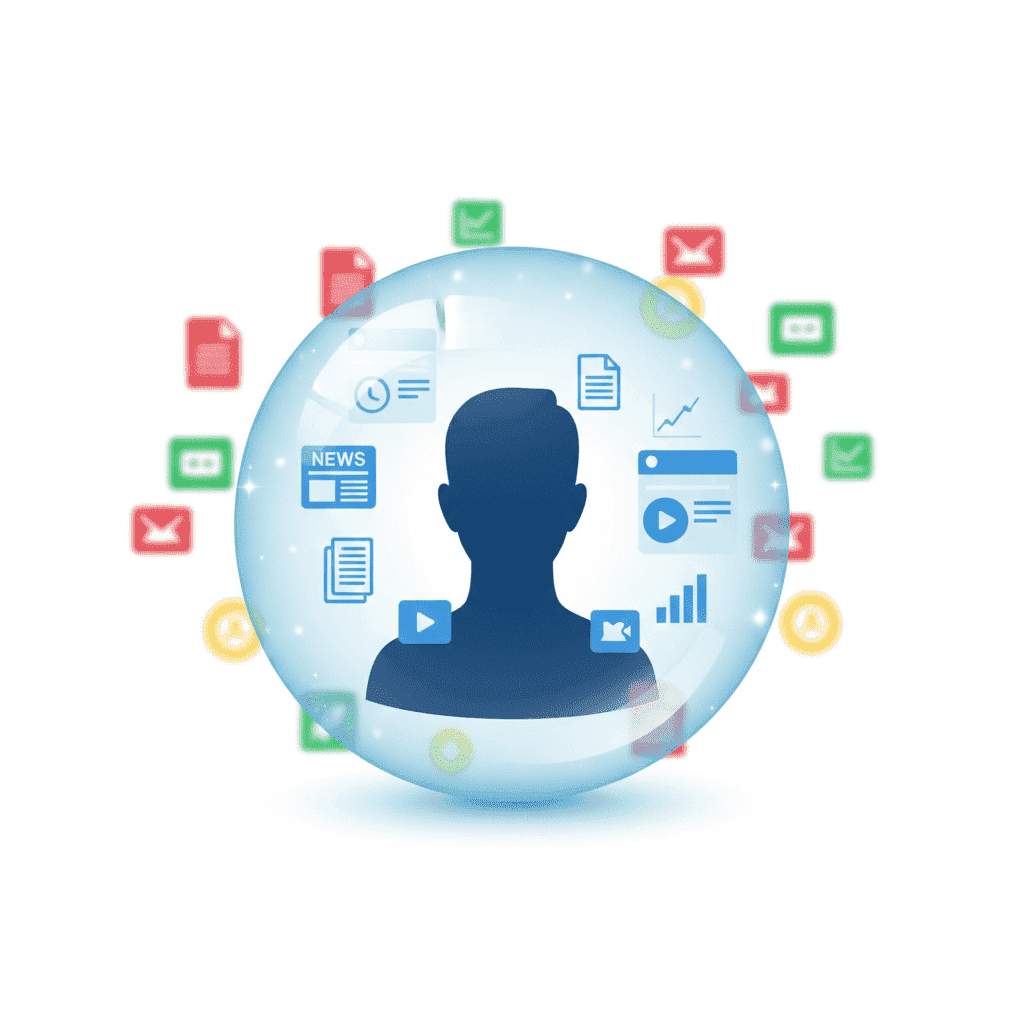
Personalizace obsahu je přizpůsobení obsahu (reklam, článků, videí) konkrétnímu uživateli na základě jeho zájmů a chování.
Personalizace je sice pohodlná, ale má i svá rizika, na která si musíme dávat pozor.
Je důležité si uvědomit, že algoritmy existují a ovlivňují to, co vidíš.
V dnešním digitálním světě je důležité si uvědomit, že obsah, který konzumujeme, je často filtrován a přizpůsobován právě nám. To může být pohodlné, ale zároveň nás to může uzavřít do "informační bubliny". Schopnost rozpoznat, že nám algoritmy něco doporučují, a kriticky přemýšlet o tom, proč to dělají, je klíčová pro naši digitální gramotnost. Učíme se tak být aktivními uživateli, kteří si sami vybírají, jaké informace chtějí přijímat, a nenechávají se jen pasivně vést.
Sociální sítě a streamovací služby používají sofistikované algoritmy, které rozhodují, jaký obsah uvidíš:
Algoritmus analyzuje chování milionů uživatelů a hledá vzorce. Pokud uživatelé, kteří sledovali videa A a B, často sledují i video C, a ty jsi sledoval A a B, algoritmus ti doporučí C. "Uživatelé jako ty sledují také..."
Algoritmus analyzuje vlastnosti obsahu (žánr, klíčová slova, délka) a doporučuje podobný obsah tomu, co jsi sledoval. "Protože jsi sledoval akční filmy, doporučujeme další akční film."
Moderní algoritmy používají neuronové sítě, které se učí z miliard interakcí. Optimalizují pro engagement metrics – čas sledování, lajky, komentáře, sdílení. Cíl: udržet tě na platformě co nejdéle.
Algoritmy jsou mocné nástroje, ale mají temnou stránku:
Algoritmus ti ukazuje obsah, který odpovídá tvým názorům a zájmům. Postupně vidíš čím dál jednostrannější pohled na svět. Lidé s odlišnými názory mají úplně jiný "feed" – jako by žili v jiném světě.
V online komunitách se obklopuješ lidmi se stejnými názory. Tvé přesvědčení se posiluje, protože neslyšíš protiargumenty. To vede k polarizaci společnosti.
Sociální sítě jsou záměrně navrženy, aby vyvolávaly závislost: nekonečné scrollování (nikdy nedojdeš na konec), červené notifikace (vyvolávají nutkání), autoplay (další video začne automaticky).
Jak si udržet zdravý vztah s technologiemi?
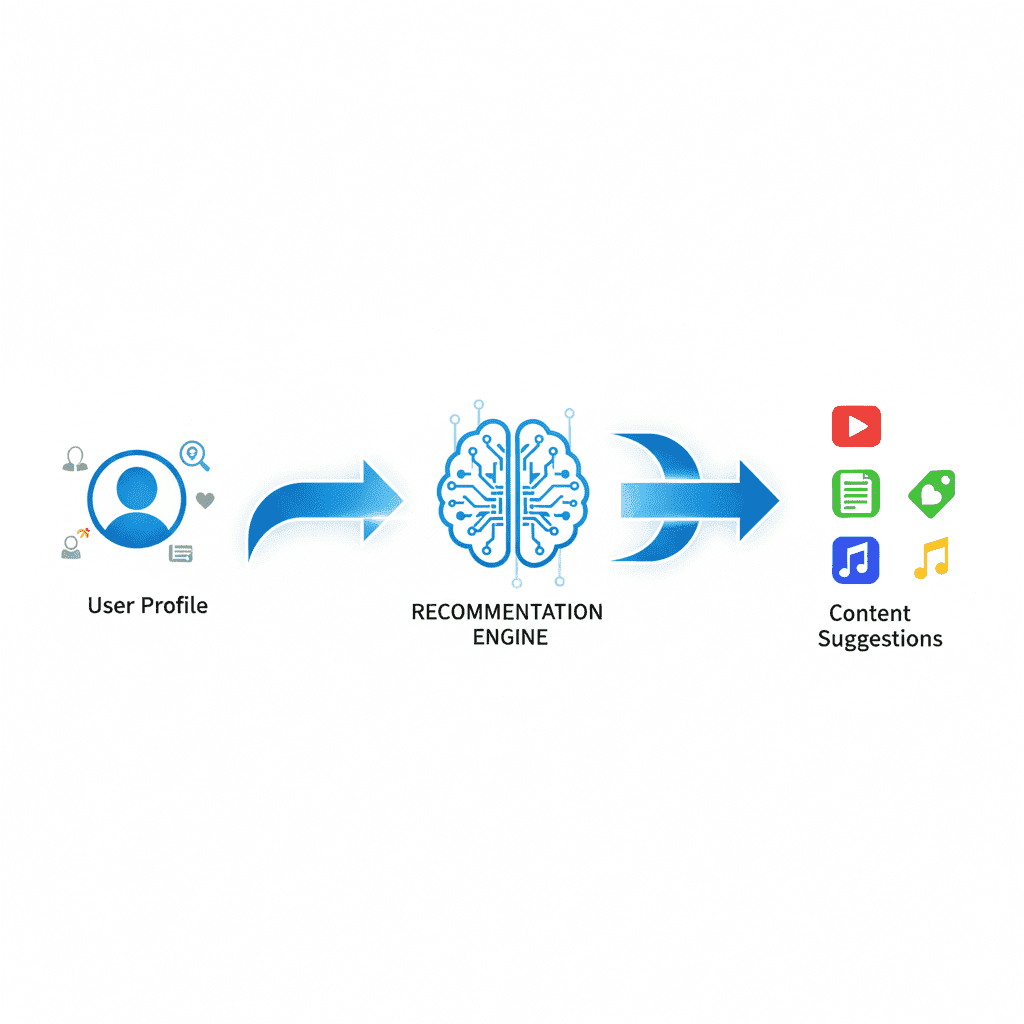
Moderní doporučovací systémy jsou komplexní a používají kombinaci mnoha technik:
Algoritmy jako ty na TikToku nebo YouTube používají hluboké neuronové sítě, které zpracovávají obrovské množství dat: co sleduješ, jak dlouho, co přeskočíš, kam klikneš, kdy se odhlásíš. Síť se neustále učí a přizpůsobuje.
Algoritmy jsou optimalizovány pro maximální "engagement" – interakci uživatele. Problém? Extrémní, kontroverzní nebo šokující obsah generuje více interakcí než nudné fakty. Algoritmus proto přirozeně upřednostňuje senzace před pravdou.
Algoritmy nejsou neutrální – mají reálné dopady na společnost:
Když každý vidí jiný "feed" přizpůsobený jeho názorům, lidé přestávají chápat, proč druzí smýšlejí jinak. To vede k polarizaci – krajní levice a pravice se vzdalují a dialog je nemožný.
Algoritmy se naučily, že emocionální reakce (hněv, strach, radost) vedou k větší interakci. Proto upřednostňují obsah, který vyvolává silné emoce – i když je nepravdivý nebo škodlivý.
Ani samotní vývojáři přesně nevědí, proč algoritmus doporučuje konkrétní obsah. Neuronová síť s miliony parametrů je příliš složitá na pochopení. To ztěžuje odhalování a opravu problémů.
Společnost začíná reagovat na problémy s algoritmy:
Nařízení EU z roku 2022, které ukládá velkým platformám povinnosti: transparentnost algoritmů, možnost vypnout personalizaci, ochrana nezletilých, rychlejší mazání nelegálního obsahu.
Uživatelé by měli mít možnost vidět obsah chronologicky (od nejnovějšího) místo algoritmického řazení. Některé platformy to již nabízejí.
Hnutí za etický design technologií. Založil ho Tristan Harris, bývalý designér Google. Cílem je změnit metriky úspěchu z "času na platformě" na "kvalitu času".
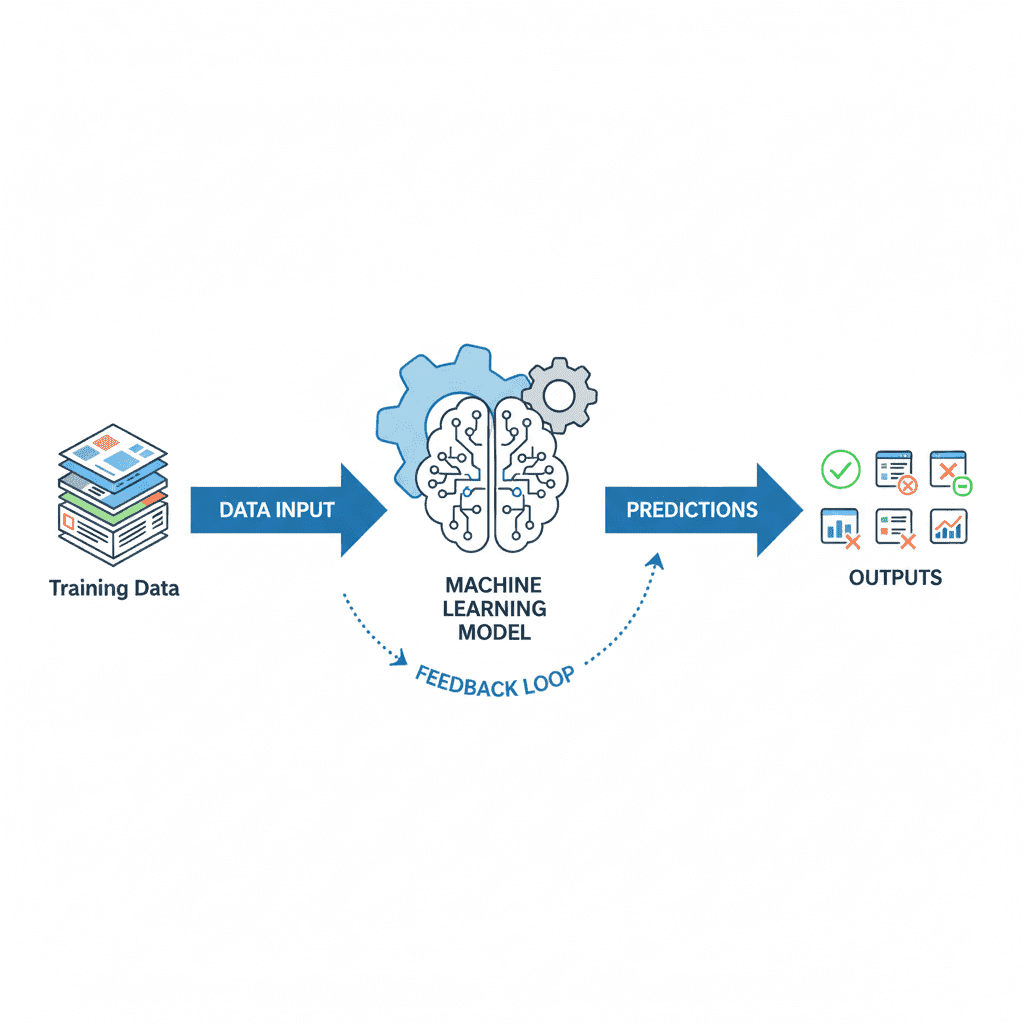
Jako IT specialista možná budeš pracovat na systémech, které využívají algoritmy strojového učení. Pochopení základů ML ti pomůže.
# pip install scikit-learn
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import train_test_split
import numpy as np

# Jednoduchý příklad: klasifikace
# Data: [věk, hodiny_online] -> typ_uživatele (0=pasivní, 1=aktivní)
X = np.array([
    [15, 2], [16, 5], [14, 1], [17, 6],
    [15, 4], [16, 3], [18, 7], [14, 2]
])
y = np.array([0, 1, 0, 1, 1, 0, 1, 0])

# Rozdělení na tréninkovou a testovací sadu
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25)

# Trénování modelu
model = KNeighborsClassifier(n_neighbors=3)
model.fit(X_train, y_train)

# Predikce
novy_uzivatel = [[16, 5]]  # 16 let, 5 hodin online
predikce = model.predict(novy_uzivatel)
print(f"Predikce: {'aktivní' if predikce[0] == 1 else 'pasivní'}")
# Content-based filtering - doporučování podle podobnosti
from collections import defaultdict

class DoporuceniFilmu:
    def __init__(self):
        self.filmy = {}  # {nazev: [zanry]}
        self.hodnoceni = defaultdict(dict)  # {uzivatel: {film: hodnoceni}}

    def pridej_film(self, nazev, zanry):
        self.filmy[nazev] = zanry

    def hodnotit(self, uzivatel, film, hvezdicky):
        self.hodnoceni[uzivatel][film] = hvezdicky

    def podobnost(self, film1, film2):
        """Počet společných žánrů."""
        zanry1 = set(self.filmy[film1])
        zanry2 = set(self.filmy[film2])
        return len(zanry1 & zanry2)

    def doporuc(self, uzivatel):
        """Doporuč filmy podobné těm, co uživatel hodnotil dobře."""
        oblibene = [f for f, h in self.hodnoceni[uzivatel].items() if h >= 4]
        viděné = set(self.hodnoceni[uzivatel].keys())

        skore = {}
        for film in self.filmy:
            if film not in viděné:
                skore[film] = sum(self.podobnost(film, ob) for ob in oblibene)

        return sorted(skore.items(), key=lambda x: x[1], reverse=True)[:5]

# Použití
dp = DoporuceniFilmu()
dp.pridej_film("Matrix", ["akce", "scifi"])
dp.pridej_film("Terminátor", ["akce", "scifi"])
dp.pridej_film("Titanic", ["drama", "romance"])
dp.pridej_film("Avatar", ["akce", "scifi", "fantasy"])
dp.pridej_film("Notebook", ["drama", "romance"])

dp.hodnotit("jan", "Matrix", 5)
dp.hodnotit("jan", "Titanic", 2)

print(dp.doporuc("jan"))  # Doporučí akce/scifi filmy
# pip install textblob
from textblob import TextBlob

def analyzuj_sentiment(text):
    """Vrátí sentiment textu (-1 až 1)."""
    blob = TextBlob(text)
    return {
        'polarita': blob.sentiment.polarity,  # -1 (negativní) až 1 (pozitivní)
        'subjektivita': blob.sentiment.subjectivity,  # 0 (objektivní) až 1 (subjektivní)
        'hodnoceni': 'pozitivní' if blob.sentiment.polarity > 0 else
                     'negativní' if blob.sentiment.polarity < 0 else 'neutrální'
    }

# Příklady
recenze = [
    "This product is amazing! I love it!",
    "Terrible quality, waste of money.",
    "It's okay, nothing special."
]

for r in recenze:
    print(f"{r[:30]}... -> {analyzuj_sentiment(r)['hodnoceni']}")
Jako IT specialista musíš psát kód, který je odolný vůči útokům. Tato sekce shrnuje klíčové principy.
| # | Zranitelnost | Prevence |
|---|---|---|
| 1 | Injection (SQL, Command) | Parametrizované dotazy |
| 2 | Broken Authentication | MFA, silná hesla, rate limiting |
| 3 | Sensitive Data Exposure | Šifrování, HTTPS, .gitignore |
| 4 | XSS (Cross-Site Scripting) | Escapování výstupu, CSP |
| 5 | CSRF | CSRF tokeny, SameSite cookies |
# ❌ ŠPATNĚ: SQL Injection
query = f"SELECT * FROM users WHERE id = {user_input}"

# ✅ SPRÁVNĚ: Parametrizovaný dotaz
cursor.execute("SELECT * FROM users WHERE id = %s", (user_input,))

# ❌ ŠPATNĚ: XSS
html = f"<div>Vítej, {username}</div>"

# ✅ SPRÁVNĚ: Escapování
from html import escape
html = f"<div>Vítej, {escape(username)}</div>"

# ❌ ŠPATNĚ: Path Traversal
file_path = f"/uploads/{user_input}"

# ✅ SPRÁVNĚ: Validace cesty
import os
safe_name = os.path.basename(user_input)
file_path = os.path.join("/uploads", safe_name)

# ❌ ŠPATNĚ: Hardcoded secrets
API_KEY = "sk-1234567890abcdef"

# ✅ SPRÁVNĚ: Environment variables
import os
API_KEY = os.environ.get("API_KEY")
# Nástroje pro automatickou kontrolu bezpečnosti

# Python - Bandit (security linter)
pip install bandit
bandit -r src/

# Python - Safety (kontrola závislostí)
pip install safety
safety check

# JavaScript - npm audit
npm audit

# Obecně - SonarQube, Snyk, CodeQL