V minulé kapitole jsme se naučili, že data jsou jako stopy pro detektiva. Ale co se stane, když detektiv stopu špatně pochopí? Může obvinit nevinného! Podobně i my můžeme z dat vyvodit úplné nesmysly, pokud si nedáme pozor. Tomuto chybnému pochopení říkáme chyba v interpretaci. Pojďme se podívat na nejčastější detektivní omyly v digitálním světě.
Co je to interpretace dat? (Opakování)
Interpretace dat je proces, kdy se snažíme pochopit, co nám data říkají. Dáváme jim smysl a snažíme se z nich vytvořit užitečnou informaci.
2. Největší chyba: Spojení, které klame
Toto je chyba, kterou dělají i dospělí! Jen proto, že se dvě věci dějí ve stejnou dobu, neznamená to, že jedna způsobuje druhou.
Příklad: Čápi nosí děti?
Někdo si všiml, že ve vesnicích, kde je více čapích hnízd, se rodí více dětí. Znamená to, že čápi nosí děti? Samozřejmě, že ne! Je to jen náhoda, nebo za tím může být něco jiného.
Vysvětlení: Větší vesnice mají více domů, a tedy více komínů pro čapí hnízda. A ve větších vesnicích také žije více lidí, takže se tam logicky narodí více dětí. Společnou příčinou je velikost vesnice, ne čápi!
Proč je to důležité?
Kdybychom věřili, že čápi nosí děti, mohli bychom začít stavět umělá hnízda, abychom měli více dětí. To by ale nefungovalo a jen bychom zbytečně utráceli peníze. Správné pochopení příčiny a následku je klíčové pro správná rozhodnutí.
3. Další časté chyby
Dělání závěrů z mála zkušeností
Představ si, že poprvé ochutnáš špenát a nechutná ti. Znamená to, že špenát je špatné jídlo a nikomu nechutná? Ne. Znamená to jen, že nechutná tobě. Abychom mohli říct, jestli je špenát oblíbený, museli bychom se zeptat mnoha lidí.
Příklad: Tvůj kamarád si koupil nový telefon a hned se mu rozbil. Znamená to, že všechny telefony této značky jsou špatné? Ne nutně. Možná měl jen smůlu na jeden vadný kus.
Když grafy a obrázky lžou
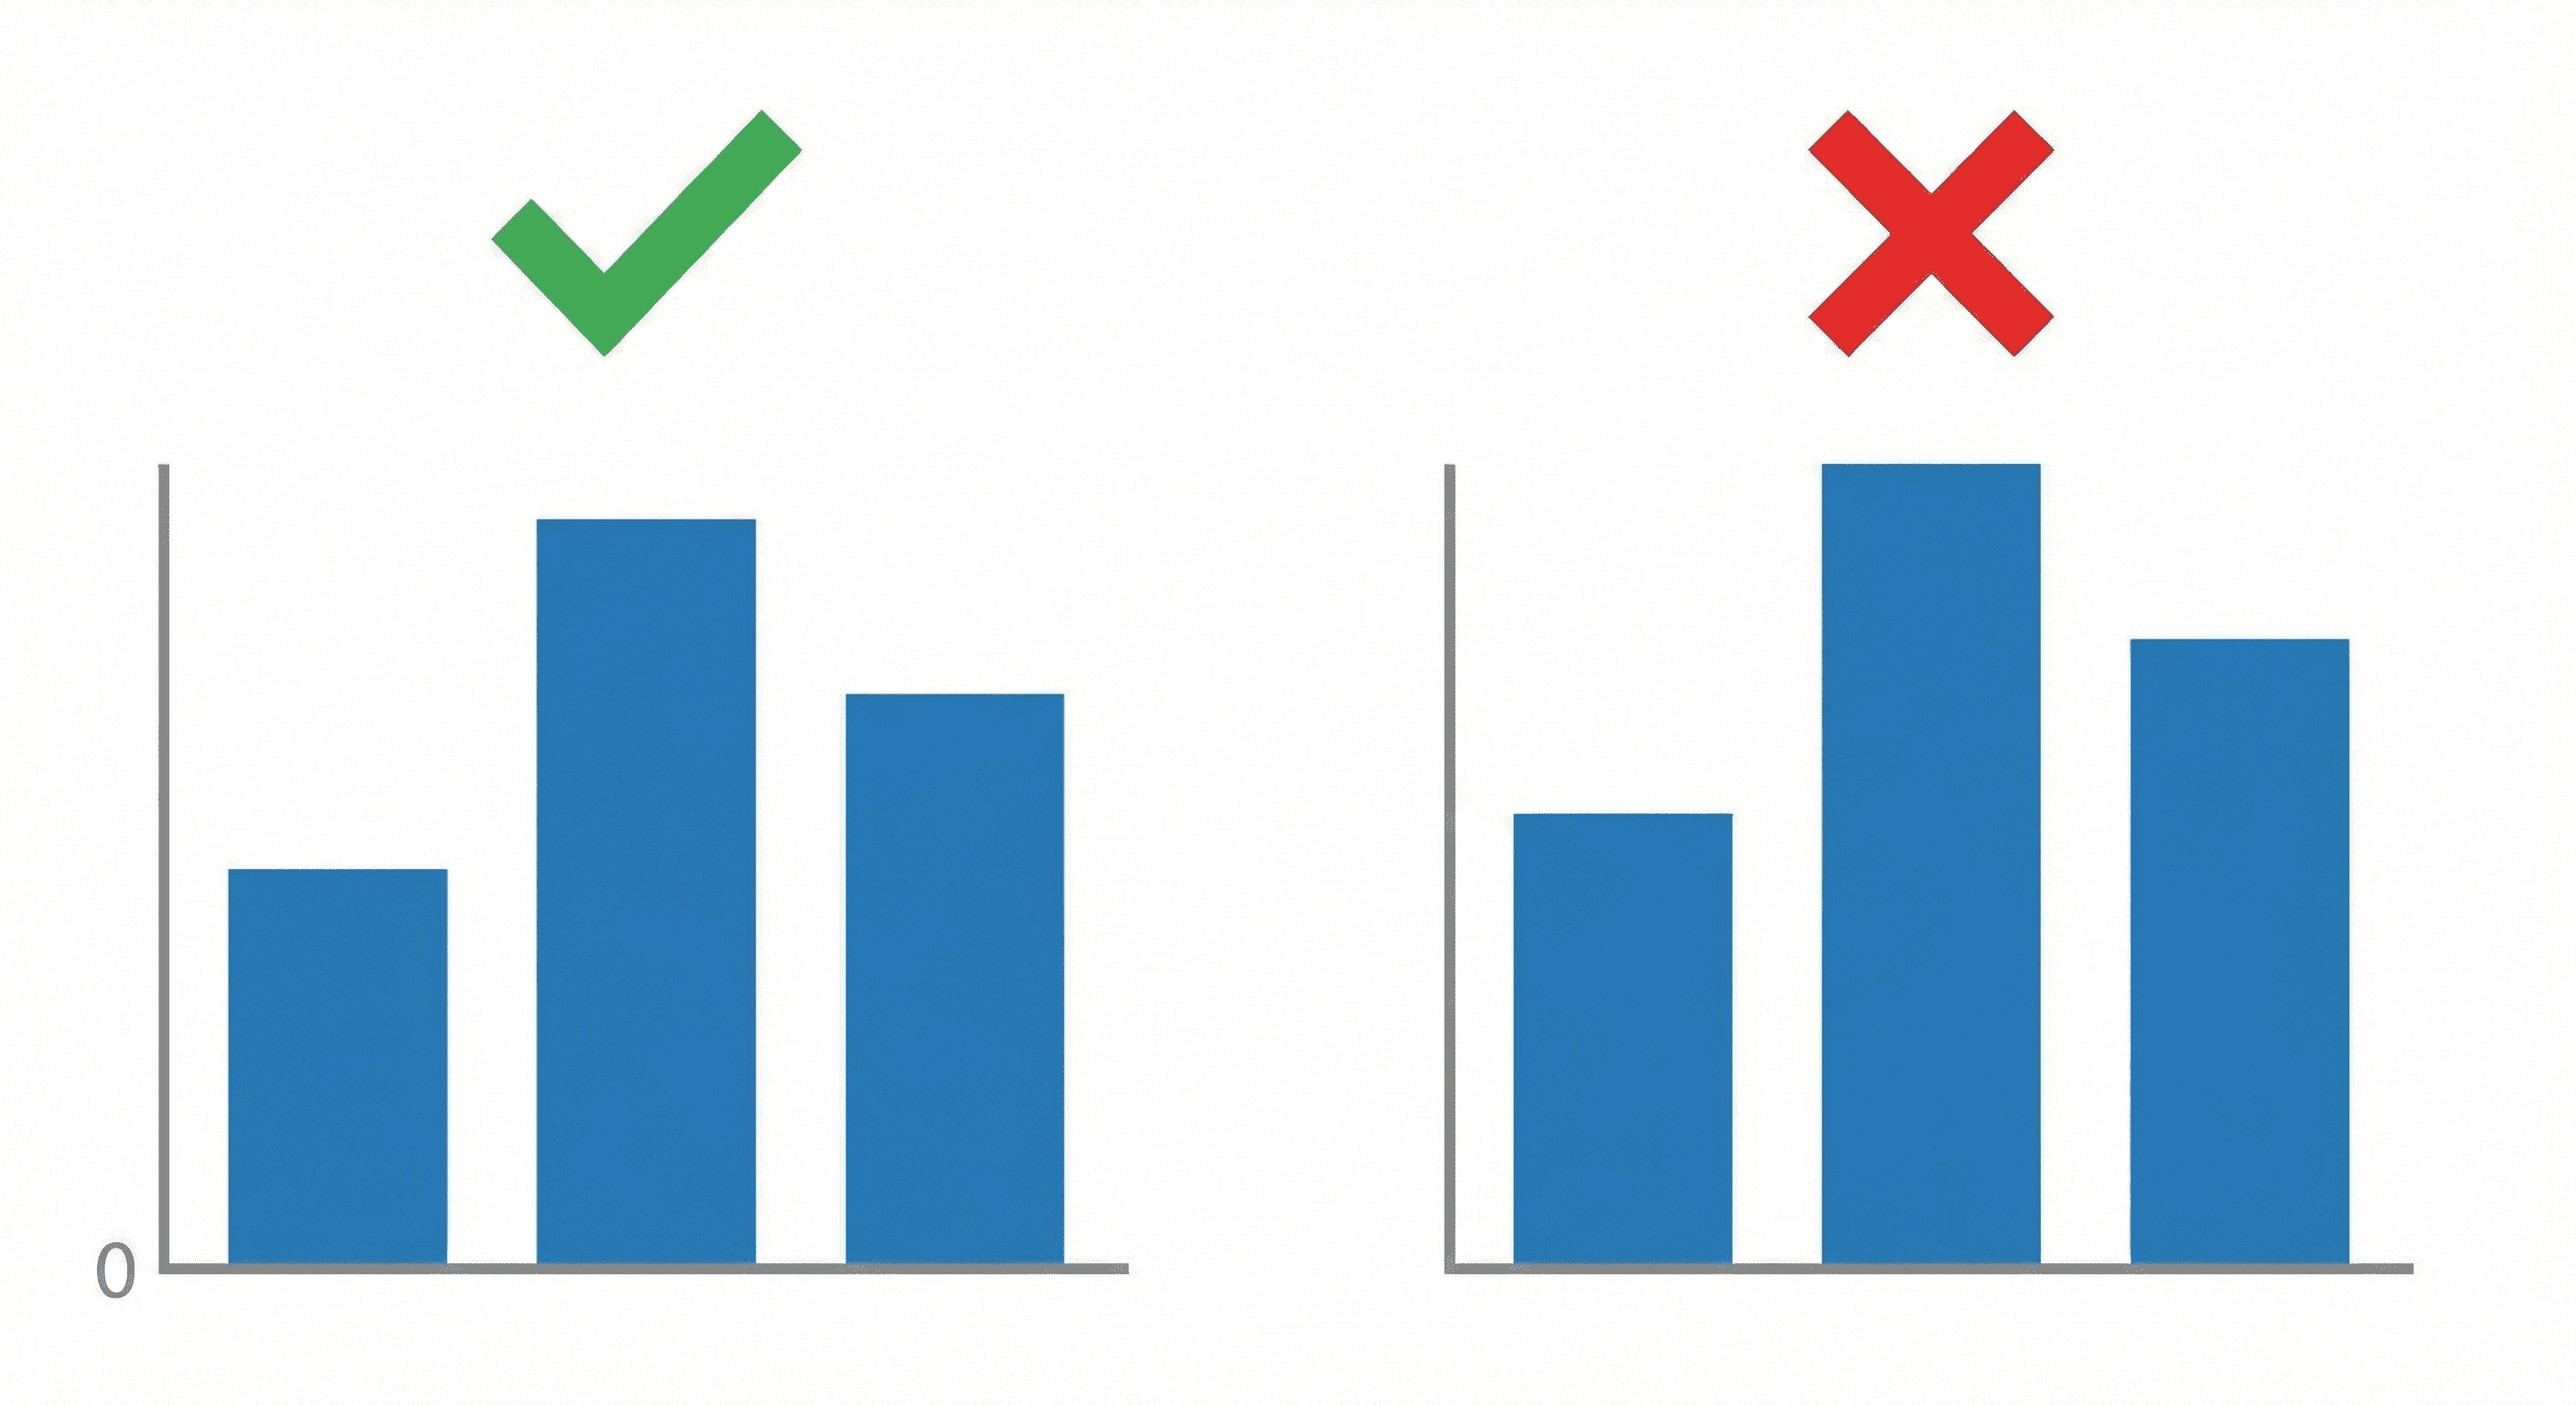
Grafy nám mají pomoci rychle pochopit data. Ale dají se snadno upravit tak, aby vypadaly jinak, než jaká je skutečnost. Mohou přehánět nebo naopak něco skrývat.
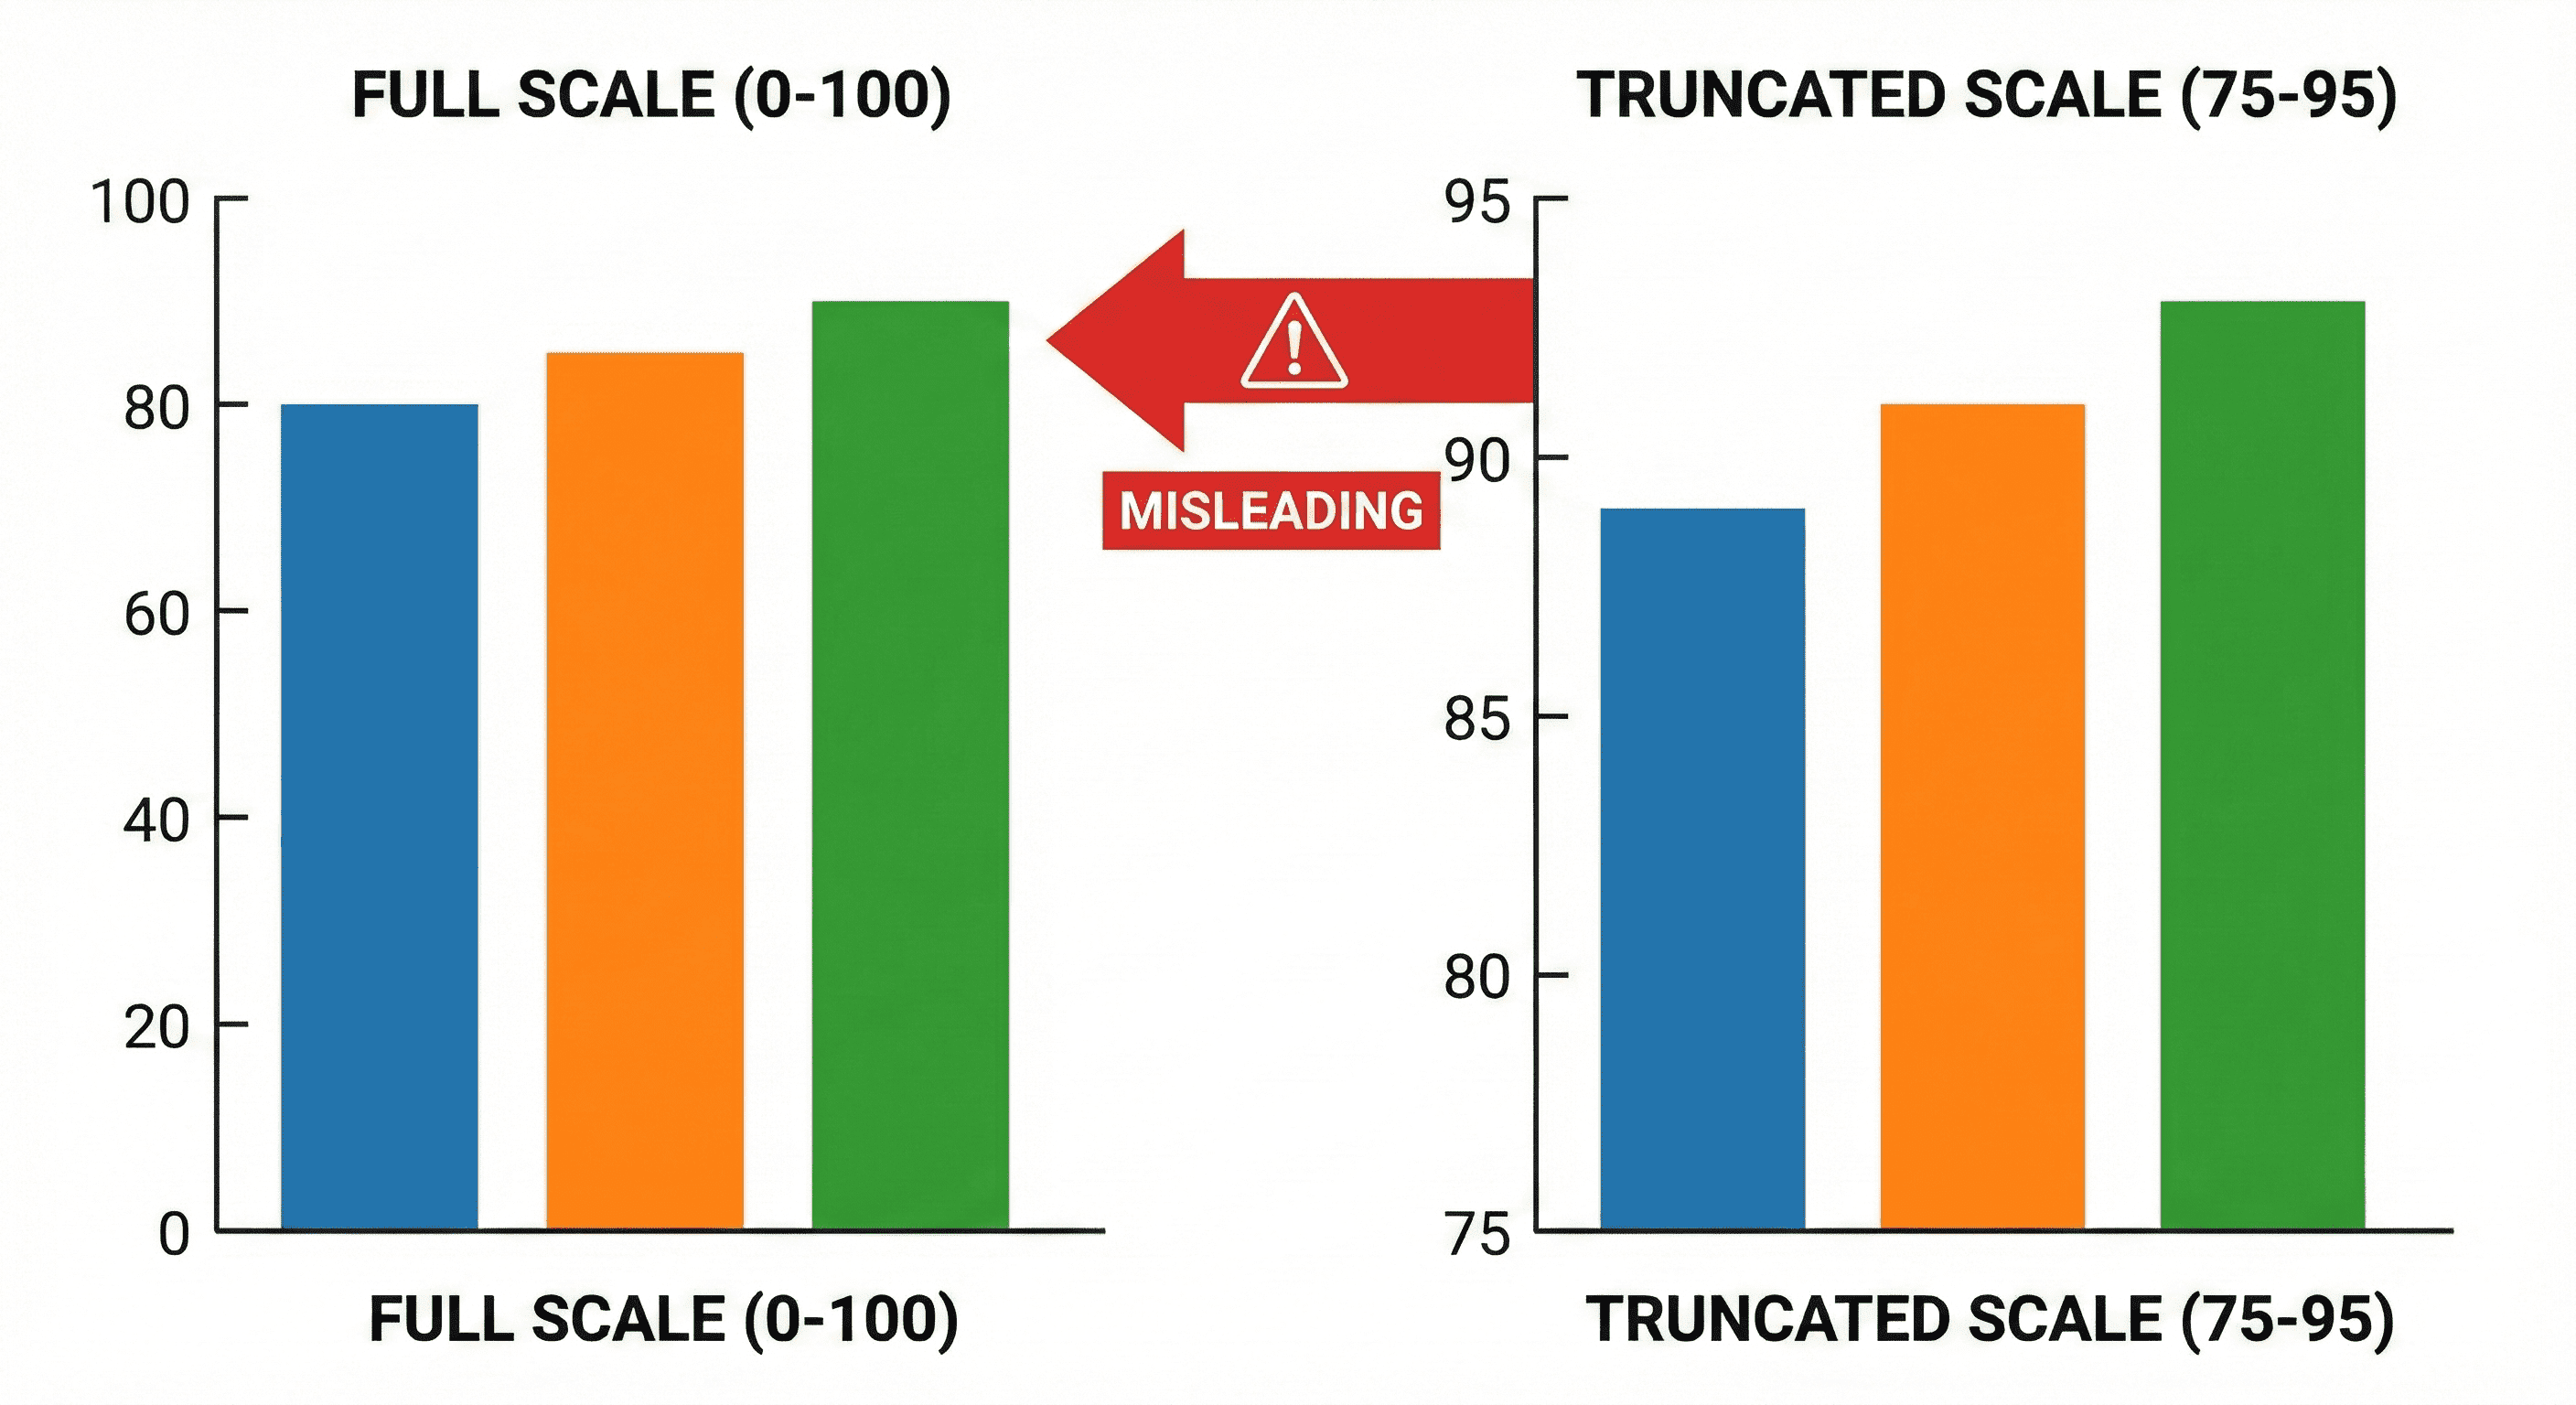
Manipulace s grafem - poctivá vs. podvodná osa Y
Příklad: Reklama na nový prací prášek ukazuje dva grafy. Jeden ukazuje "běžný prášek" a druhý "náš nový prášek". Graf "našeho" prášku je nakreslený tak, aby vypadal mnohem vyšší a lepší, i když ve skutečnosti je rozdíl jen malý.
4. Jak se nenechat napálit?
Abys neudělal chybu, stačí se držet několika jednoduchých pravidel:
Čtyři pravidla kritického myšlení
Používej selský rozum: Vždy se zamysli, jestli to, co vidíš, dává smysl. Opravdu může zmrzlina za to, že se někdo utopí?
Ptej se: Kdo data sbíral? Proč je sbíral? Není za tím nějaký skrytý úmysl?
Hledej další důkazy: Než něčemu uvěříš, zkus si to ověřit z jiného zdroje.
Nevěř všemu, co vidíš: Buď opatrný u grafů a statistik v reklamách nebo na internetu. Mohou být upravené, aby tě ovlivnily.
Otázky k zamyšlení
Vzpomeneš si na nějakou reklamu, která používala čísla nebo grafy, aby tě přesvědčila? Byla podle tebe pravdivá?
Proč je nebezpečné dělat závěry jen z jedné nebo dvou zkušeností?
Jak bys vysvětlil mladšímu sourozenci, že čápi nenosí děti, i když to tak podle dat z vesnic vypadá?
Úkoly pro praxi
Najdi klamavý graf: Zkus na internetu najít nějaký článek nebo reklamu, kde je podle tebe graf použitý tak, aby vypadal lépe než ve skutečnosti. Ulož si obrázek a zkus vysvětlit, v čem je ten trik.
Vytvoř vlastní příklad: Vymysli vlastní vtipný příklad na záměnu "děje se to spolu" a "jedno způsobuje druhé" (jako se zmrzlinou a utonutím). Můžeš ho nakreslit jako komiks.
Průzkum ve škole: Zeptej se 5 spolužáků, jestli hrají počítačové hry. Potom se zeptej 5 učitelů. Můžeš na základě toho říct, že "všichni mladí hrají hry a dospělí ne"? Proč ano, nebo proč ne? Diskutujte o tom ve třídě.
Člověk a digitální svět
V digitálním světě se setkáváme s obrovským množstvím informací, které jsou nám často prezentovány v grafech a statistikách. Je velmi důležité umět tyto informace kriticky hodnotit a rozpoznat, kdy se nás někdo snaží oklamat nebo ovlivnit. Schopnost rozlišit mezi skutečnými fakty a zkreslenými údaji je klíčová pro to, abychom se mohli správně rozhodovat a nenechali se manipulovat. Pamatuj, že ne všechno, co vidíš na internetu, je pravda!
* Rozšíření pro pokročilé
Statistické chyby a manipulace
V profesionální praxi se setkáváme s pokročilejšími způsoby, jak mohou být data zkreslena:
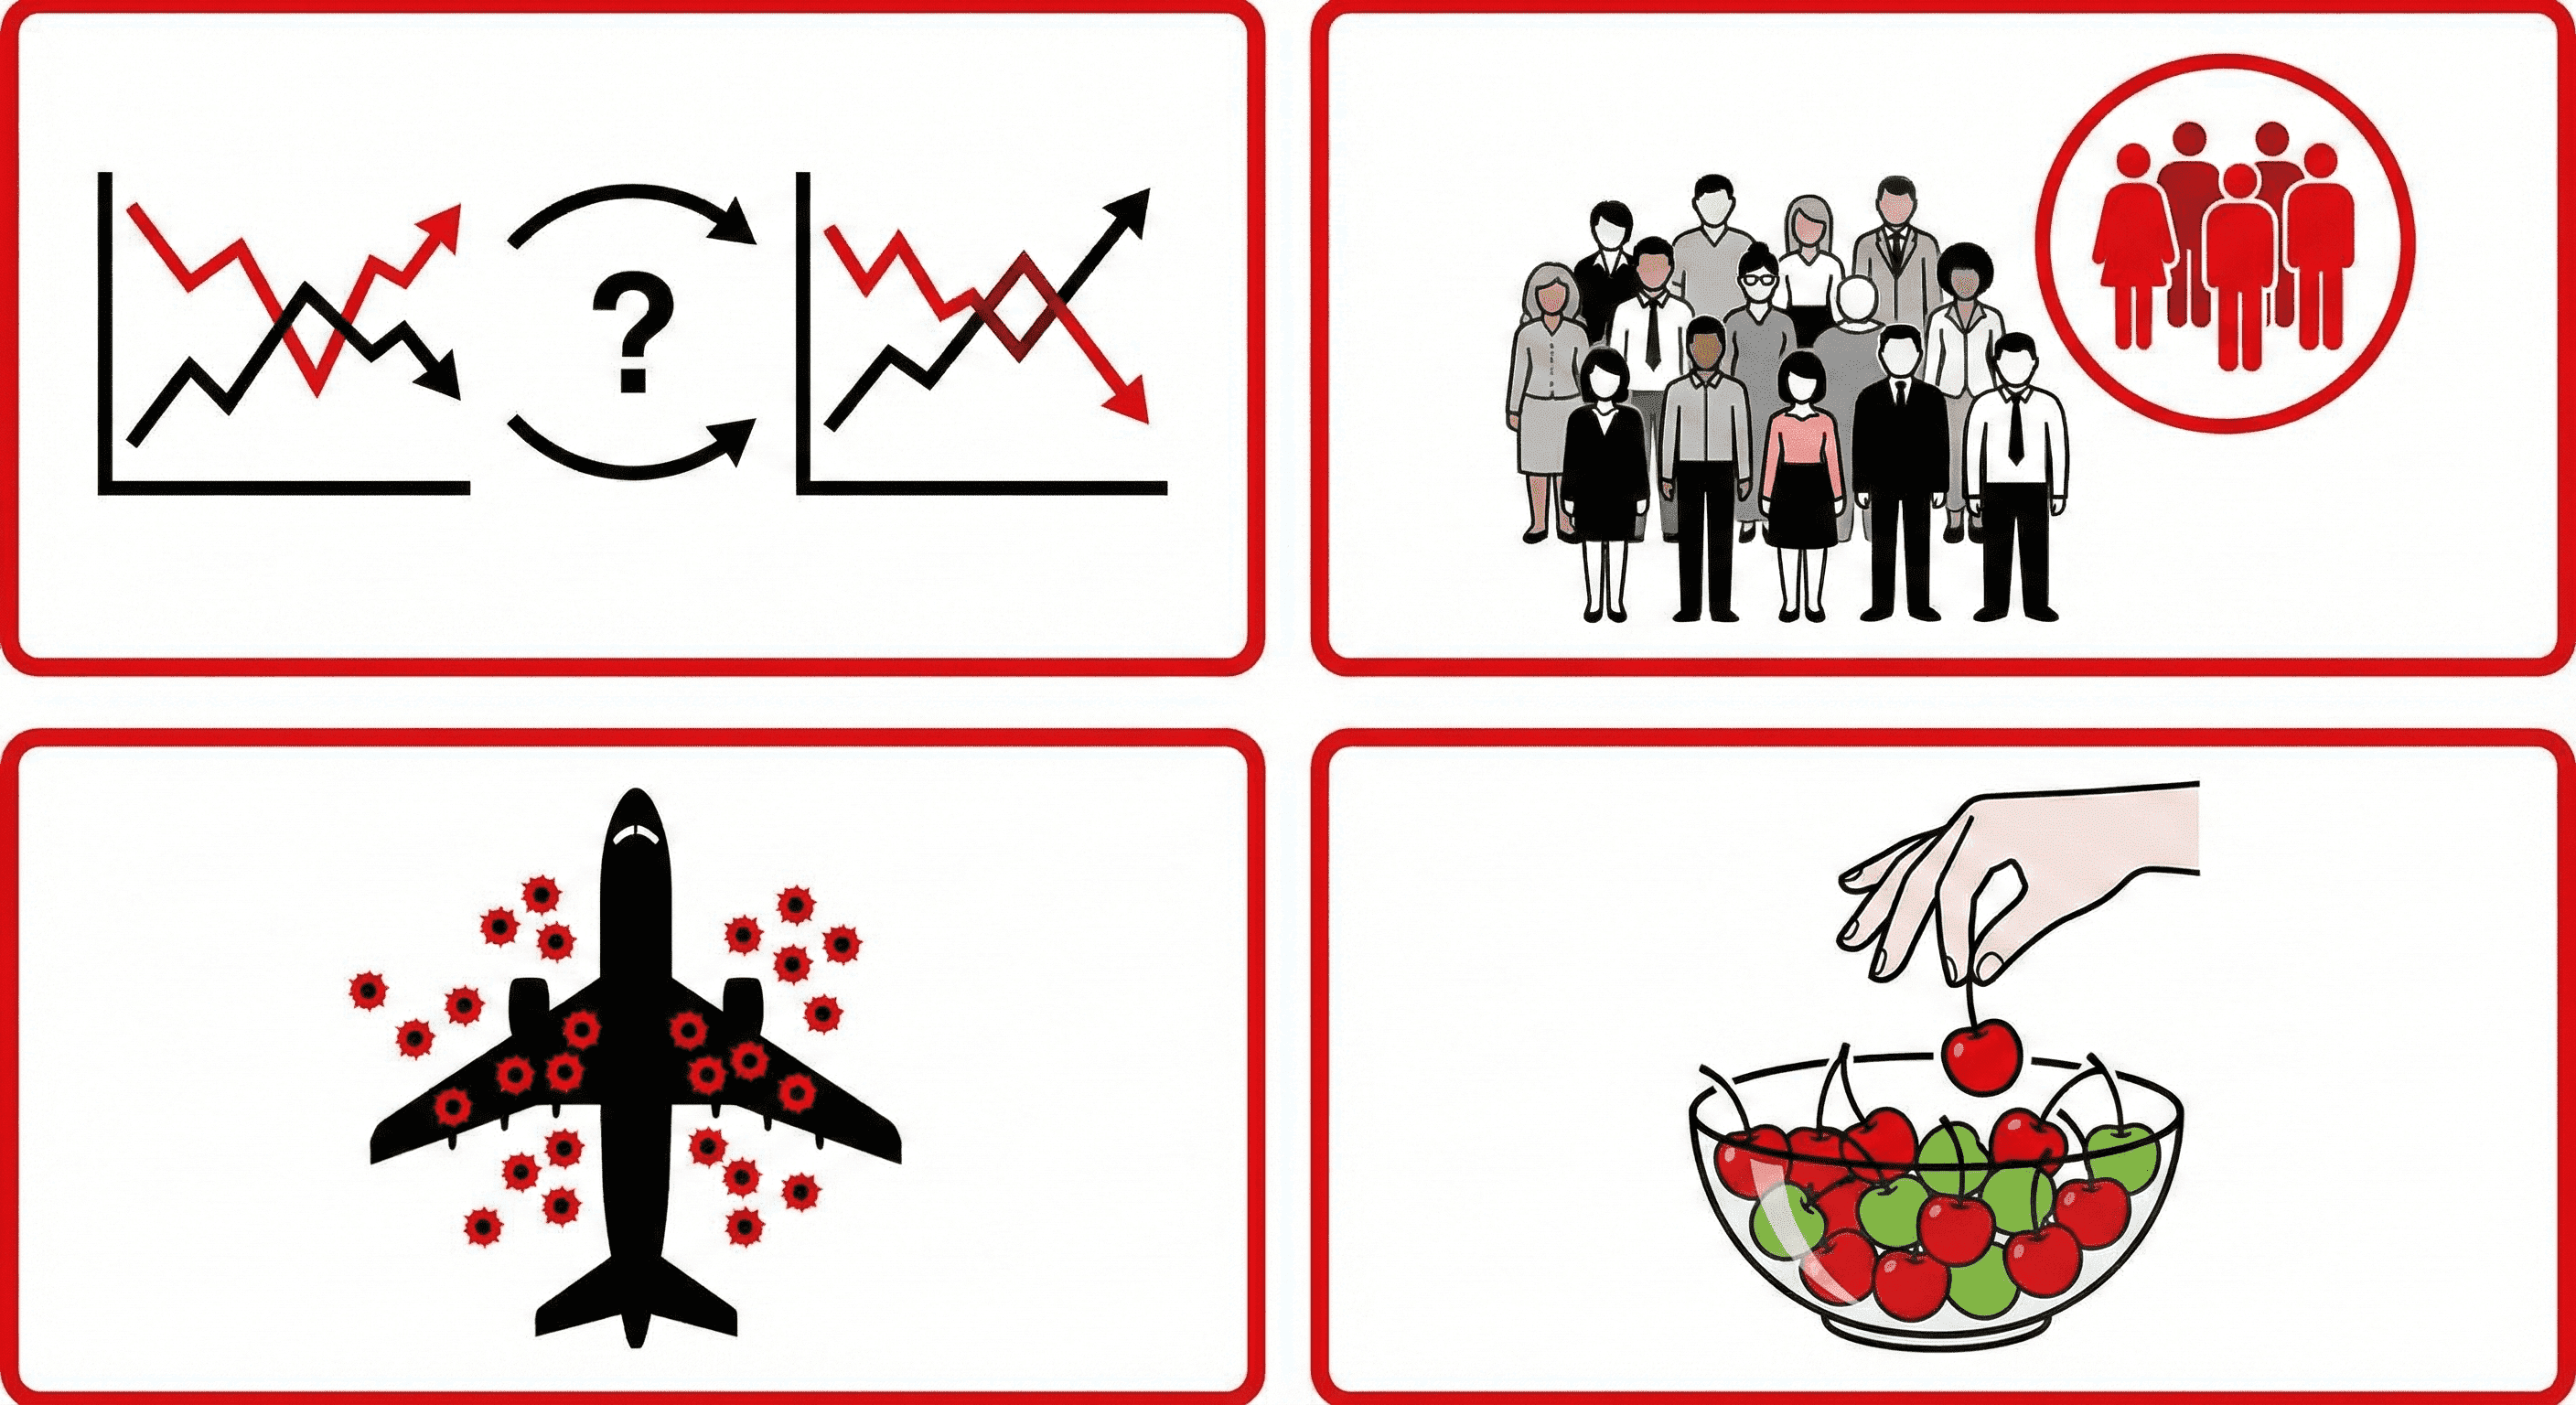
Korelace vs. kauzalita: To, že dvě věci spolu souvisejí (korelují), neznamená, že jedna způsobuje druhou. Vždy hledej třetí proměnnou.
Výběrová chyba (selection bias): Když zkoumaný vzorek nereprezentuje celou populaci. Např. ptát se na kvalitu jídla jen hostů, kteří přišli podruhé.
Přežití (survivorship bias): Zaměřujeme se jen na "přeživší" a ignorujeme ty, kteří neuspěli.
Cherry-picking: Vybírání jen těch dat, která podporují náš názor.
Kontrola kvality dat
Profesionálové používají tyto techniky pro ověření dat:
Křížová validace: Porovnání dat z více nezávislých zdrojů.
Statistická významnost: Ověření, že výsledek není jen náhoda.
Velikost vzorku: Čím větší vzorek, tím spolehlivější závěry.
Typy statistických chyb a zkreslení
* Úkoly pro pokročilé
Excel – Analýza dat: Vytvoř v Excelu tabulku s fiktivními daty o prodeji zmrzliny a počtu utonutí za 12 měsíců. Vytvoř graf, který ukazuje korelaci. Pak v textovém poli vysvětli, proč jedno nezpůsobuje druhé.
Excel – Podvodný graf: Vezmi stejná data a vytvoř DVA grafy – jeden poctivý (osa Y od 0) a jeden "podvodný" (osa Y od vysoké hodnoty). Porovnej vizuální dojem.
Word – Kritická analýza: Najdi na internetu článek s grafy nebo statistikami. V dokumentu Word analyzuj: Jaký je zdroj? Je graf poctivý? Jaký vzorek byl použit? Co mohlo být vynecháno?
Scratch – Simulace: Vytvoř ve Scratchi program, který simuluje hod mincí 100×. Zobraz výsledky (kolik orlů, kolik panen). Spusť vícekrát a porovnej – vždy je to jiné? Proč?
** Rozšíření pro maturitní obory
Podrobně: Statistické chyby v praxi
V předchozí sekci jsme zmínili několik typů statistických chyb. Pojďme si je rozebrat podrobněji s praktickými příklady:
1. Korelace vs. Kauzalita – hloubkový rozbor
Korelace znamená, že dvě věci se mění společně. Kauzalita znamená, že jedna způsobuje druhou.
Příklad: V městech s více hasiči je více požárů. Znamená to, že hasiči způsobují požáry? Ne! Větší města mají více hasičů I více požárů – obojí způsobuje velikost města.
Jak rozlišit:
Hledej třetí proměnnou, která může ovlivňovat obě.
Zvaž časovou posloupnost – příčina musí předcházet následek.
Hledej mechanismus – jak by jedna věc mohla způsobovat druhou?
2. Výběrová chyba (Selection Bias)
Nastává, když zkoumaný vzorek není reprezentativní pro celou populaci.
Příklad: Průzkum "Kolik lidí čte knihy?" provedený v knihovně ukáže, že skoro všichni čtou. Ale v knihovně jsou právě ti, kdo čtou!
Jak se vyhnout: Náhodný výběr, stratifikovaný výběr, dostatečně velký vzorek.
3. Survivorship Bias (Chyba přeživších)
Zaměřujeme se na úspěšné případy a ignorujeme neúspěšné.
Slavný příklad: Ve 2. světové válce chtěli posílit letadla. Zkoumali, kam dostávala zásahy ta, která se vrátila. Ale měli posílit místa, kam zásahy NEMĚLA – protože ta, která tam dostala zásah, se nevrátila!
4. Jak vytvořit poctivý graf
Osa Y vždy začíná od 0 (nebo jasně označ, že ne).
Používej konzistentní měřítko.
Uváděj zdroj dat a velikost vzorku.
Nepoužívej 3D efekty – zkreslují proporce.
Poctivý vs. nepoctivý graf - stejná data, jiný dojem
** Úkoly pro maturitní obory
Excel – Analýza korelace: Stáhni reálný dataset (např. z data.gov.cz). Najdi dvě proměnné, které korelují. Vytvoř bodový graf s trendovou přímkou. Vypočítej korelační koeficient (=CORREL). Napiš, zda je to korelace nebo kauzalita.
PowerPoint – Prezentace o chybách: Vytvoř prezentaci "5 nejčastějších statistických chyb" (10-12 snímků). Ke každé chybě uveď příklad z reálného života, obrázek a jak se jí vyhnout.
Canva – Infografika Survivorship Bias: Vytvoř v Canvě infografiku vysvětlující Survivorship Bias. Použij příklad s letadly nebo jiný. Exportuj jako PNG pro sdílení.
Word – Kritická analýza reklamy: Najdi reklamu, která používá statistiky nebo grafy. Analyzuj: Je graf poctivý? Jaký byl vzorek? Co reklama nezmiňuje? Napiš kritickou analýzu (1 strana A4).
Excel – Detekce outlierů: Vytvoř tabulku s 20 čísly. Vypočítej průměr a směrodatnou odchylku. Pomocí podmíněného formátování zvýrazni hodnoty, které se liší od průměru o více než 2 směrodatné odchylky (outliers).
*** Rozšíření pro IT obory
Jako budoucí IT specialista musíš rozumět tomu, jak data reprezentovat, interpretovat a jak rozpoznat chyby v datech. Tato kapitola se zaměřuje na hlubší teoretické pochopení.
Reprezentace čísel v počítači
Počítač ukládá čísla binárně, ale různé typy čísel mají různou reprezentaci:
Celá čísla (Integer)
Typ
Velikost
Rozsah
Použití
byte / int8
8 bitů
-128 až 127
Malé hodnoty, ASCII
short / int16
16 bitů
-32 768 až 32 767
Audio vzorky
int / int32
32 bitů
±2 miliardy
Běžná čísla
long / int64
64 bitů
±9 × 10¹⁸
Velká čísla, ID
Desetinná čísla (Float) a jejich problémy
Desetinná čísla se ukládají v plovoucí řádové čárce (IEEE 754). To může vést k chybám zaokrouhlování!
Pozor na chyby! V počítači: 0.1 + 0.2 ≠ 0.3 (přesně)
Výsledek je: 0.30000000000000004
Proč? Číslo 0.1 nelze přesně reprezentovat v binární soustavě, podobně jako 1/3 = 0.333... nelze přesně zapsat desítkově.
Důsledky v praxi: Nikdy neporovnávej desetinná čísla na rovnost! Místo toho kontroluj, zda je rozdíl menší než určitá tolerance.
Přetečení (Overflow) a podtečení (Underflow)
Každý datový typ má omezený rozsah. Co se stane, když ho překročíš?
Přetečení (Overflow): Číslo je příliš velké → "přeteče" a stane se záporným nebo nulou.
Podtečení (Underflow): Desetinné číslo je příliš malé → stane se nulou.
Příklad přetečení: V 8-bitovém typu: 127 + 1 = -128 (místo 128) Slavný bug: Raketa Ariane 5 (1996) explodovala kvůli přetečení – 64-bitová hodnota byla převedena do 16-bitové proměnné.
Endianita (Byte Order)
Jak jsou bajty čísla uloženy v paměti? Existují dva systémy:
Big Endian: Nejvýznamnější bajt první (jako čteme čísla). Používají síťové protokoly.
Little Endian: Nejméně významný bajt první. Používají procesory Intel a AMD.
Příklad: Číslo 0x12345678 (hex)
Big Endian: 12 34 56 78
Little Endian: 78 56 34 12
Proč je to důležité? Při přenosu dat mezi systémy s různnou endianitou musíš správně převést bajty.
Kódování textu – problémy a řešení
Kódování
Popis
Znaky
Problémy
ASCII
7 bitů
128 (jen angličtina)
Žádná diakritika
Windows-1250
8 bitů
256 (střední Evropa)
Nekompatibilní s jinými jazyky
ISO-8859-2
8 bitů
256 (Latin-2)
Zastaralé
UTF-8
1-4 bajty
1,1 milionu+
✓ Standard, doporučeno
Typický problém: Otevřeš soubor a místo "Příliš žluťoučký kůň" vidíš "PĹ™Ăliš ĹľluĹĄouÄŤkĂ˝ kĹŻĹ". Důvod: Soubor je v UTF-8, ale program ho otevřel jako Windows-1250.
Typy chyb v datech
Typ chyby
Popis
Příklad
Chybějící data
Hodnota chybí
Věk: (prázdné)
Neplatná data
Hodnota mimo rozsah
Věk: -5, Teplota: 500 °C
Nekonzistentní data
Různé formáty
"1.5.2024", "2024-05-01", "May 1"
Duplicity
Stejný záznam vícekrát
Dva zákazníci se stejným ID
Typová chyba
Špatný datový typ
Věk: "patnáct" místo 15
Binární vs. textová reprezentace
Data můžeme ukládat dvěma základními způsoby:
Binární: Efektivnější (menší soubory), ale nečitelné pro člověka. Příklady: obrázky, videa, zkompilované programy.
Textová: Čitelná pro člověka, větší soubory, snazší debugging. Příklady: CSV, JSON, XML, HTML.
*** Úkoly pro IT obory
Přetečení: Jaký bude výsledek 200 + 100 v 8-bitovém unsigned integer (rozsah 0-255)? Vysvětli proč.
Kódování: Otevři textový soubor s českým textem v programu Poznámkový blok. Ulož ho jako UTF-8, pak jako ANSI. Porovnej velikost souborů a vysvětli rozdíl.
Endianita: Číslo 0xABCD má být uloženo v paměti. Jak bude vypadat v Big Endian a Little Endian?
Float chyby: Pomocí kalkulačky nebo Excelu ověř, že 0.1 + 0.2 není přesně 0.3. Jak bys řešil porovnání desetinných čísel?
Analýza dat: Najdi v nějaké veřejné datové sadě (např. z data.gov.cz) alespoň 3 různé typy chyb v datech. Zdokumentuj je.